
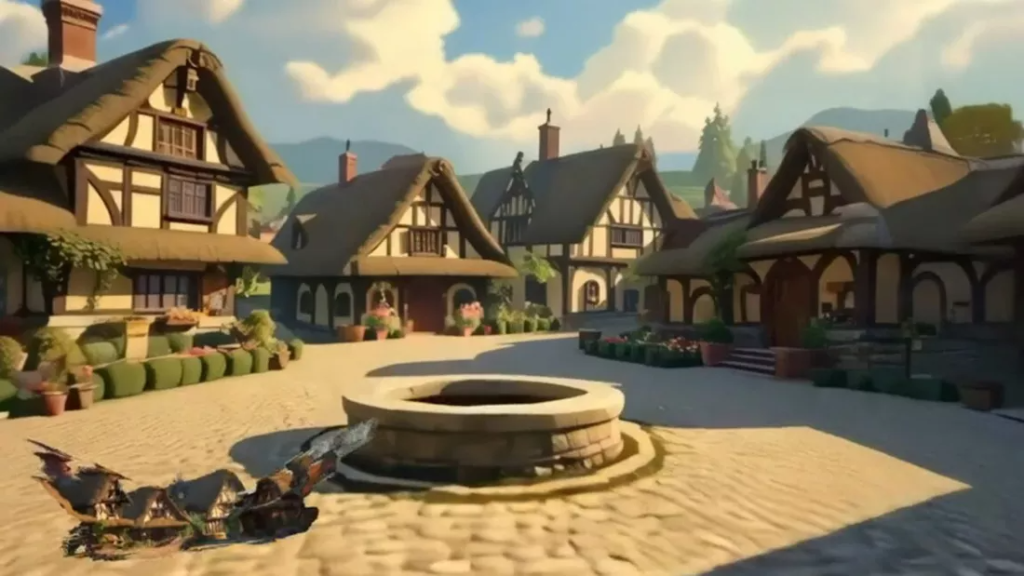
Depășirea limitelor 3D cu modelul HunyuanWorld-Voyager
Tencent a dezvăluit un nou model de inteligență artificială care generează videoclipuri simulând mișcarea printr-un spațiu tridimensional, folosind doar o singură imagine de intrare. Numit HunyuanWorld-Voyager, sistemul produce clipuri scurte cu informații de profunzime, care pot fi ulterior reconstruite în nori de puncte 3D – deschizând noi posibilități pentru creatorii de conținut, dar rămânând sub nivelul modelelor 3D complet interactive.
HunyuanWorld-Voyager este un model cu ponderi deschise (open-weights) care produce secvențe de 49 de cadre – aproximativ două secunde de video – dar utilizatorii pot lega clipuri pentru a crea câteva minute de material video continuu. Ars Technica notează că, atunci când spectatorii schimbă perspectiva camerei virtuale, obiectele își mențin pozițiile relative, iar mediul se comportă ca și cum ar fi complet tridimensional. Deși rezultatul final este tot un videoclip bidimensional, Tencent spune că datele de profunzime incluse permit reconstrucția 3D fără tehnici tradiționale de modelare.
Voyager funcționează prin combinarea unei imagini de intrare cu o traiectorie a camerei definită de utilizator. Utilizatorii specifică mișcări precum panoramarea, înclinarea sau avansarea prin scenă, iar sistemul generează simultan videoclipuri color și hărți de profunzime. Când un obiect apare în videoclip, rezultatul de profunzime înregistrează distanța sa relativă într-o aliniere precisă.
O componentă secundară, numită memoria cache a lumii (world cache) în raportul tehnic al Tencent, stochează nori de puncte 3D pe măsură ce sistemul generează noi cadre. Pentru fiecare mișcare a camerei, Voyager proiectează aceste puncte înapoi în două dimensiuni și le folosește ca referință. Acest proces asigură că cadrele ulterioare se aliniază cu conținutul generat anterior, ajutând la menținerea consistenței spațiale.
Modelul se protejează împotriva distorsiunilor după generarea cadrelor, convertindu-le în puncte 3D, care sunt reintroduse în sistem pentru comparație. Această buclă de feedback impune stabilitate geometrică, deși erorile se acumulează treptat. Abordarea menține un videoclip coerent timp de câteva minute, dar întâmpină dificultăți cu mișcări ale camerei mai lungi sau mai complexe, în special rotații de 360°.
Tencent a antrenat Voyager pe mai mult de 100.000 de clipuri video, inclusiv filmări din lumea reală și scene create în Unreal Engine. Acest set de date la scară largă a învățat sistemul cum se mișcă de obicei camerele în medii tridimensionale. O conductă automată separată a generat intrări de antrenament prin scanarea clipurilor video pentru a calcula profunzimea pentru fiecare cadru, eliminând necesitatea datelor etichetate manual.
Sistemul necesită cantități masive de putere de calcul. Rularea modelului la o rezoluție de doar 540p necesită cel puțin 60 GB de memorie GPU, cu 80 GB recomandați pentru rezultate optime. Tencent a publicat ponderile modelului pe Hugging Face și suportă atât configurații cu un singur GPU, cât și cu mai multe GPU-uri. Folosind framework-ul xDiT, compania spune că performanța se scalează orizontal – un sistem cu opt GPU-uri poate procesa imagini de aproximativ 6,7 ori mai repede decât o rulare cu un singur GPU.
Majoritatea modelelor video generative produc cadre unul câte unul, fără a impune consistență geometrică. Sora de la OpenAI, de exemplu, prioritizează realismul vizual în detrimentul coerenței 3D. Voyager adoptă o abordare diferită, menținând în mod explicit geometria de-a lungul cadrelor prin potrivirea de modele ghidată de feedback, mai degrabă decât printr-o înțelegere 3D completă.
Pe benchmark-ul WorldScore, dezvoltat de cercetătorii de la Stanford pentru a evalua sistemele de generare a lumilor 3D, Voyager a obținut un scor de 77,62. Raportul Tencent notează că acesta a fost cel mai mare dintre modelele comparabile, depășind WonderWorld cu 72,69 și CogVideoX-I2V cu 62,15. Voyager a excelat în consistența stilului și calitatea subiectivă, dar a rămas în urma WonderWorld la controlul camerei.
Deși scorurile sale sunt promițătoare, sistemul vine cu o avertizare notabilă: mai multe restricții de licențiere. La fel ca alte modele din suita Hunyuan a Tencent, Tencent interzice utilizarea Voyager în Uniunea Europeană, Regatul Unit sau Coreea de Sud. Compania necesită, de asemenea, acorduri suplimentare pentru implementări comerciale care deservesc mai mult de 100 de milioane de utilizatori activi lunar.
Calitatea rezultatului reprezintă un pas înainte pentru mediile generate de AI. Cu toate acestea, costul computațional ridicat și limitările actuale în coerența scenei indică faptul că ar putea dura ceva timp până când sisteme precum Voyager vor putea susține experiențe complet interactive, în timp real. Deocamdată, sistemul este probabil cel mai valoros pentru generarea de videoclipuri și fluxuri de lucru experimentale de reconstrucție 3D.





