
Pe măsură ce sarcinile logice devin mai complexe, acuratețea scade până la 4 – 24%
Din ce în ce mai multe companii de Inteligență Artificială (IA) susțin că modelele lor pot raționa. Două studii recente contrazic acest lucru. Când li se cere să își demonstreze logica, majoritatea modelelor eșuează sarcina – demonstrând că nu raționează atât de mult pe cât reproduc tipare. Rezultatul: răspunsuri încrezătoare, dar nu inteligente.
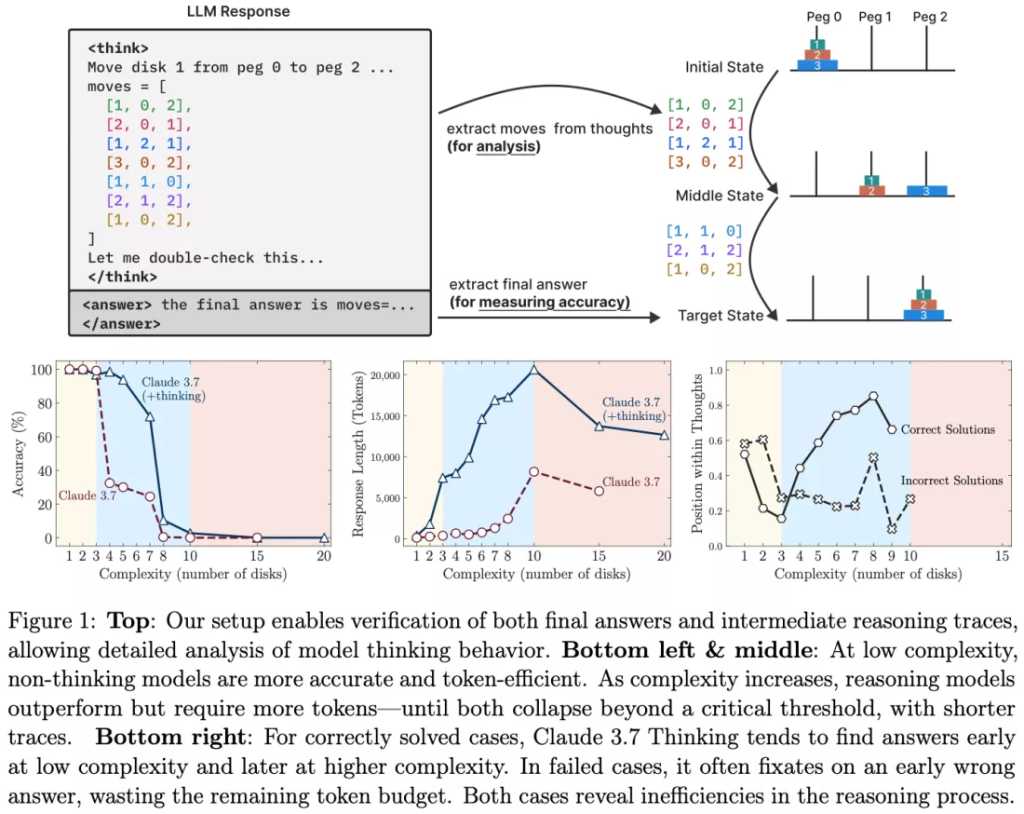
Cercetătorii Apple au descoperit o slăbiciune cheie în cele mai mediatizate sisteme IA de astăzi – acestea eșuează la rezolvarea puzzle-urilor care necesită raționament pas cu pas. Într-o nouă lucrare, echipa a testat mai multe modele de top pe Turnul din Hanoi, un vechi puzzle logic, și a constatat că performanța s-a prăbușit pe măsură ce complexitatea a crescut.
Puzzle-ul Turnul din Hanoi este simplu: mută o stivă de discuri de pe un pivot pe altul, respectând reguli privind ordinea și dimensiunea discurilor. Pentru oameni, este un test clasic de planificare și logică recursivă. Pentru modelele lingvistice antrenate să prezică următorul token, provocarea constă în aplicarea unor constrângeri fixe pe parcursul mai multor pași, fără a pierde din vedere obiectivul.
Cercetătorii Apple nu au cerut doar modelelor să rezolve puzzle-ul – le-au cerut să își explice pașii. Deși majoritatea s-au descurcat cu două sau trei discuri, logica lor s-a destrămat pe măsură ce numărul discurilor a crescut. Modelele au enunțat greșit regulile, au contrazis pașii anteriori sau au făcut cu încredere mișcări invalide – chiar și cu instrucțiuni de tip „lanț de gândire” (chain-of-thought). Pe scurt, nu raționau – ghiceau.
Aceste constatări reflectă un studiu din aprilie, când cercetători de la ETH Zurich și INSAIT au testat modele AI de top pe probleme de la Olimpiada de Matematică din SUA din 2025 – o competiție care necesită demonstrații scrise complete. Din aproape 200 de încercări, niciuna nu a produs o soluție perfectă. Unul dintre performanții mai buni, Gemini 2.5 Pro de la Google, a obținut 24% din totalul punctelor – nu prin rezolvarea a 24% dintre probleme, ci prin credite parțiale la fiecare încercare. o3-mini de la OpenAI abia a depășit 2%.
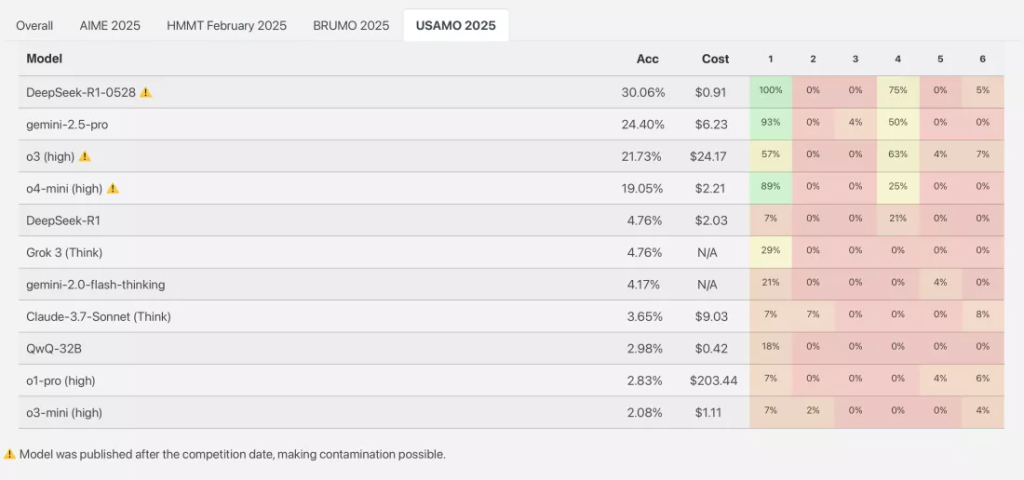
Modelele nu doar că au greșit răspunsurile – au făcut erori elementare, au omis pași și s-au contrazis, părând în același timp încrezătoare. Într-o problemă, un model a început bine, dar a exclus cazuri valide fără explicație. Altele au inventat constrângeri bazate pe particularități ale antrenamentului, cum ar fi încadrarea întotdeauna a răspunsurilor finale – chiar și atunci când nu se potrivea contextului.
Gary Marcus, un critic de lungă durată al entuziasmului exagerat legat de IA, a numit constatările Apple „destul de devastatoare pentru modelele lingvistice mari”.
„Este cu adevărat jenant că LLM-urile (Large Language Models) nu pot rezolva în mod fiabil Hanoi”, a scris el. „Dacă nu poți folosi un sistem AI de miliarde de EUR pentru a rezolva o problemă pe care Herb Simon, unul dintre adevărații ‘părinți ai IA’, a rezolvat-o cu IA în 1957, și pe care studenții din primul semestru la IA o rezolvă în mod curent, șansele ca modele precum Claude sau o3 să atingă AGI (Inteligența Generală Artificială) par cu adevărat îndepărtate.”
Chiar și atunci când li s-au dat algoritmi expliciți, performanța modelelor nu s-a îmbunătățit. Co-liderul studiului, Iman Mirzadeh, a spus-o direct:
„Procesul lor nu este logic și inteligent.”
Rezultatele sugerează că ceea ce pare a fi raționament este adesea doar potrivire de tipare – fluent din punct de vedere statistic, dar neancorat în logică.
Nu toți experții au fost critici. Sean Goedecke, un inginer software specializat în sisteme AI, a considerat eșecul ca fiind revelator.
„Modelul decide imediat ‘generarea manuală a tuturor acelor mișcări este imposibilă’, deoarece ar necesita urmărirea a peste o mie de mișcări. Așa că se învârte încercând să găsească o scurtătură și eșuează”, a scris el în analiza sa asupra studiului Apple. „Ideea cheie aici este că, dincolo de un anumit prag de complexitate, modelul decide că sunt prea mulți pași de raționat și începe să caute scurtături inteligente. Deci, dincolo de opt sau nouă discuri, abilitatea investigată se schimbă în tăcere de la ‘poate modelul raționa prin secvența Turnului din Hanoi?’ la ‘poate modelul să vină cu o soluție generalizată pentru Turnul din Hanoi care să evite necesitatea de a raționa prin secvență?’”
În loc să demonstreze că modelele sunt incapabile de raționament, Goedecke a sugerat că descoperirile subliniază modul în care sistemele AI își adaptează comportamentul sub presiune – uneori inteligent, alteori nu. Eșecul nu constă doar în raționamentul pas cu pas, ci în abandonarea sarcinii atunci când devine prea greoaie.
Companiile de tehnologie evidențiază adesea raționamentul simulat ca pe o descoperire revoluționară. Lucrarea Apple confirmă că și modelele ajustate fin pentru raționamentul de tip „lanț de gândire” tind să atingă un prag limită odată ce sarcina cognitivă crește – de exemplu, atunci când urmăresc mișcări dincolo de șase discuri în Turnul din Hanoi. Logica internă a modelelor se destramă, unele reușind doar un succes parțial prin imitarea explicațiilor raționale. Puține demonstrează o înțelegere consecventă a cauzei și efectului sau a comportamentului orientat spre scop.
Rezultatele studiilor Apple și ETH Zurich contrastează puternic cu mFsodul în care companiile își promovează aceste modele – ca fiind capabile de raționament, putând gestiona sarcini complexe, în mai mulți pași. În practică, ceea ce trece drept raționament este adesea doar o completare automată avansată cu pași suplimentari. Iluzia inteligenței provine din fluență și formatare, nu dintr-o perspectivă reală.
Lucrarea Apple nu propune soluții ample. Cu toate acestea, se aliniază cu apelurile tot mai numeroase pentru abordări hibride care combină modelele lingvistice mari cu logica simbolică, verificatori sau constrângeri specifice sarcinii. Aceste metode s-ar putea să nu facă IA cu adevărat inteligentă, dar ar putea ajuta la prevenirea prezentării ca fapte a răspunsurilor greșite, dar oferite cu încredere.
Până când astfel de progrese se vor materializa, raționamentul simulat va rămâne probabil ceea ce sugerează și numele: simulat. Este util – uneori impresionant – dar departe de inteligența autentică.





